Глава 1 Надежные, масштабируемые и удобные в сопровождении приложения

Надежность

Книга
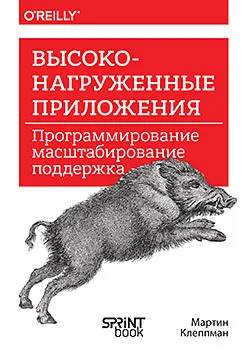
Высоконагруженные приложения. Программирование, масштабирование, поддержка

Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems

Главная книга для тех, кто хочет научиться создавать крупные, быстрые и надежные ИТ-системы вроде Telegram, Netflix или крупных интернет-магазинов.
Раздел 1.2 · Что такое надёжность

Работать правильно, даже когда всё идёт не так

Каждый интуитивно понимает, что значит «надёжно». Книга раскладывает это ожидание на четыре части — и называет надёжностью способность выполнять их, даже когда что-то ломается.

01 · ФУНКЦИЯ

Делает то, что ожидает пользователь

Приложение выполняет ожидаемую пользователем функцию — это база, без которой остальное бессмысленно.

02 · ОШИБКИ ПОЛЬЗОВАТЕЛЯ

Переживает ошибочные действия

Выдерживает ошибки пользователя и применение программного обеспечения неожиданным образом.

03 · ПРОИЗВОДИТЕЛЬНОСТЬ

Достаточно быстро для своего сценария

Производительность достаточна для текущего сценария — при предполагаемой нагрузке и объёме данных.

04 · БЕЗОПАСНОСТЬ

Не пускает, кого не звали

Предотвращает любой несанкционированный доступ и злоупотребления.

Если всё это — «работать нормально», то надёжность — это продолжать работать нормально даже в случае проблем. Возможные проблемы называются сбоями, а системы, созданные в расчёте на них, — устойчивыми к сбоям.
Ключевое различие

Сбой ≠ отказ

В разговорной речи эти слова путают, а книга разводит их намеренно: вся идея устойчивых систем живёт в промежутке между ними. Мы учимся строить надёжные системы из ненадёжных частей.

СБОЙ · FAULT

Один компонент отклонился от нормы

Умер диск, зависла одна из копий базы, оператор ввёл не ту команду. Снизить вероятность сбоев до нуля невозможно.

перехватываем
УСТОЙЧИВОСТЬ К СБОЯМ

Фильтр между сбоем и отказом

Резервирование, изоляция, перезапуск, откат. Задача проектирования — предотвращать переход сбоев в отказы.

до отказа не доходит
ОТКАЗ · FAILURE

Система перестала работать для пользователя

Вся система в целом прекратила предоставлять требуемый сервис. Именно этого мы избегаем.

Сбой случится всё равно → его перехватывают механизмы устойчивости → до отказа он не доходит.

  • Устойчивость — только к определённым типам сбоев. Если Землю поглотит чёрная дыра, спасёт лишь хостинг данных в космосе — удачи с одобрением такой статьи бюджета.
  • Сбои полезно вызывать намеренно. Звучит парадоксально — следующий слайд разбирает это на примере Chaos Monkey из Netflix.
  • Исключение — безопасность. Обычно устойчивость важнее предотвращения, но утечку не «вылечишь»: если атакующий уже забрал данные — поздно. Здесь предотвратить важнее, чем пережить.
Парадокс устойчивых систем

Chaos Monkey: ломаем нарочно, чтобы не сломалось само

По книге, в устойчивой к сбоям системе имеет смысл повысить частоту сбоев, генерируя их умышленно — например, прерывать работу случайно выбранных процессов без предупреждения. Зачем добровольно устраивать себе аварии?

01 · ПРОБЛЕМА

Код обработки ошибок почти не выполняется

Многие критические ошибки происходят из-за недостаточной обработки ошибок. Этот код пишут «на всякий случай» и годами не запускают — пока сбой не случится по-настоящему, никто не знает, работает ли он.

02 · ПРИЁМ NETFLIX

Сервис, который убивает случайные машины

Chaos Monkey случайным образом выключает виртуальные машины Netflix прямо в проде — в рабочее время, когда инженеры на месте. Ни один сервис не может рассчитывать, что его машина будет жить вечно.

03 · РЕЗУЛЬТАТ

Механизмы устойчивости проверяются каждый день

Умышленные сбои гарантируют постоянное тестирование резервирования, перезапуска и отката. Растёт уверенность, что при «естественном» сбое система справится — уверенность, а не надежда.

Порядок важен: сначала строим систему, где сбой не превращается в отказ, и только потом выпускаем обезьяну это проверять. Из одной обезьяны у Netflix выросла целая Simian Army (2011–2018): Latency Monkey вносил задержки в вызовы между сервисами, Chaos Gorilla имитировал отказ целой зоны доступности AWS. А из практики выросла отдельная дисциплина — chaos engineering.
Источник сбоев 1 из 3

Аппаратные сбои: случайные и независимые

Умирают диски, появляются дефекты в памяти, отключается электропитание, кто-то выдернул не тот сетевой кабель. При большом количестве машин это происходит постоянно.

10–50 лет
среднее время наработки на отказ (MTTF) одного диска — статистическая частота отказов по парку, а не срок жизни каждого
≈ 1 в день
отказ диска в кластере хранения на 10 000 дисков: делим 10 000 на 10–50 лет и получаем от одного отказа за два дня до трёх в день

Первая реакция — избыточность железа

RAID-массивы, дублированное электропитание, CPU с горячей заменой, батареи и дизель-генераторы в ЦОД. Пока отказавший компонент меняют, его работу берёт на себя резервный. Отказы не исчезают, но машины работают бесперебойно годами.

Сдвиг: переживать потерю целых машин

Данных и вычислений всё больше → машин больше → отказов пропорционально больше. В облаках вроде AWS виртуалки пропадают без предупреждения: платформа ценит гибкость выше надёжности одной машины. Ответ — программные методы устойчивости вместо аппаратной избыточности или вдобавок к ней.

Бонус для эксплуатации: система из одного сервера требует планового простоя ради перезагрузки — например, чтобы накатить патч безопасности, — а устойчивая к аппаратным сбоям обновляется по узлу за раз без остановки: плавающее обновление (rolling upgrade).
Источник сбоев 2 из 3

Программные ошибки: одна на всех узлах

Аппаратные сбои случайны и независимы: диск одного сервера ничего не знает о диске другого. Систематическая ошибка в софте — наоборот: она коррелирует между узлами, поэтому системных отказов от неё гораздо больше.

Как это выглядит

  • Ошибка роняет экземпляр сервера при конкретных «плохих» входных данных. Пример — високосная секунда (leap second) 30 июня 2012: лишняя секунда в системном времени спровоцировала баг в ядре Linux, и разом зависло множество приложений.
  • Вышедший из-под контроля процесс исчерпал общий ресурс: время CPU, память, диск или полосу сети.
  • Сервис, от которого зависит система, замедлился, перестал отвечать или возвращает испорченные ответы.
  • Каскадные сбои: крошечный сбой в одном компоненте вызывает сбой в другом — и дальше по цепочке.

Что с этим делать

  • Быстрого решения нет — помогает множество мелочей.
  • Тщательно обдумывать допущения и взаимодействия внутри системы.
  • Всестороннее тестирование; изоляция процессов; возможность перезапуска после фатального сбоя.
  • Измерять, мониторить и анализировать поведение в проде.
  • Постоянная самопроверка инвариантов — условий, которые должны выполняться всегда. Например: в очередь вошло столько сообщений, сколько из неё вышло; расхождение — сразу алерт.
Такие ошибки долго спят. Приложение делает допущение о своём окружении — обычно верное. До того дня, когда это допущение по какой-то причине перестаёт быть верным.
Источник сбоев 3 из 3

Человеческий фактор: люди ненадёжны

Системы проектируют, пишут и эксплуатируют люди — и даже с самыми благими намерениями они ошибаются. Вопрос книги: как обеспечить надёжность системы, несмотря на ненадёжность людей?

№ 1
причина перебоев в крупных интернет-сервисах — ошибки людей при настройке. Железо (серверы, сеть) замешано лишь в 10–25 % случаев.

Оптимальные системы сочетают несколько подходов

Ни один пункт справа не работает сам по себе — надёжность даёт их комбинация.

  • Минимизировать возможности ошибиться. Хорошие абстракции, API и админ-интерфейсы упрощают «правильные» действия и усложняют «неправильные». Но слишком жёсткие интерфейсы люди начнут обходить — нужно равновесие.
  • Развести места, где люди чаще ошибаются, и места, где ошибка становится отказом. Полнофункциональная «песочница» с настоящими данными, где можно экспериментировать, не влияя на реальных пользователей.
  • Тестировать на всех уровнях. От модульных тестов до комплексных и ручных; автоматизация особенно ценна для пограничных случаев.
  • Быстрое и удобное восстановление. Быстрый откат конфигурации, постепенное внедрение кода на малую долю пользователей, инструменты пересчитать данные, если прошлые вычисления оказались неверны.
  • Подробный и ясный мониторинг. Метрики производительности и частоты ошибок — телеметрия, как у ракеты после отрыва от земли.
  • Управленческие практики и обучение — важно, но уже за рамками книги.
Зачем это нам

Надёжность нужна не только АЭС и авиадиспетчерам

От «обычных» приложений тоже ожидают надёжной работы — и у ненадёжности всегда есть цена.

БИЗНЕС-ПРИЛОЖЕНИЯ

Потерянные рабочие часы и юристы

Ошибки в коммерческих приложениях — это простой сотрудников и юридические риски, если цифры в отчётах оказались неточны.

ИНТЕРНЕТ-МАГАЗИНЫ

Простой = недополученный доход

Простои сайта приводят к колоссальным убыткам: недополученные доходы и ущерб для репутации.

«НЕКРИТИЧНЫЕ» ПРИЛОЖЕНИЯ

Ответственность перед пользователями

Родители хранят все фото и видео детей в вашем приложении. Что они почувствуют, если база окажется испорчена? Смогут ли они восстановить данные из резервной копии?

Иногда надёжностью жертвуют осознанно: ради экономии на разработке (прототип для нового рынка) или на эксплуатации (сервис с копеечной маржой). Но «срезать углы» нужно очень осторожно.
Не из книги · Примеряем на фронтенд

Те же три источника сбоев — в браузере

Клеппман пишет про информационные системы, но словарь раздела 1.2 переносится на фронтенд без изменений: сбой компонента не должен становиться отказом страницы.

ИсточникКак выглядит в браузереЧтобы сбой не стал отказом
Устройство и сеть пользователяПропал Wi-Fi, слабый телефон, ОС выгрузила вкладку в фонеПовторы запросов с нарастающей задержкой, офлайн-состояния, плавная деградация (graceful degradation) вместо белого экрана
Программная ошибкаНеожиданный null в ответе API роняет всё дерево компонентов; CDN ответил 502, сторонний скрипт не загрузилсяError boundaries (React; в Vue — errorCaptured): падает виджет, а не страница; валидация данных на границе; таймауты для зависимостей; мониторинг ошибок в проде
Человеческий факторОпечатка в конфиге или релиз с багом уехал сразу на 100 % пользователейПостепенная раскатка и feature flags, быстрый откат, телеметрия — три пункта из списка книги
Chaos Monkey по-фронтендерски: моки (MSW) и DevTools, которые случайно отдают 500, таймауты и обрыв сети — чтобы код обработки ошибок исполнялся каждый спринт, а не в первый инцидент. Честно: в прод с этим, как Netflix, фронтенд обычно не ходит.
Что забрать с собой

Надёжность — в четырёх строках

  • Надёжность — «продолжать работать нормально, когда что-то пошло не так». Ожидаемая функция, устойчивость к ошибкам пользователя, достаточная производительность, защита от несанкционированного доступа и злоупотреблений.
  • Сбой ≠ отказ. Сбои неизбежны; проектируем так, чтобы сбой компонента не превращался в отказ системы. Надёжные системы строятся из ненадёжных частей.
  • Три источника сбоев — три набора мер. Аппаратные: избыточность и устойчивость к потере целых машин. Программные: тестирование, изоляция, мониторинг, самопроверки. Человеческие: хорошие интерфейсы, песочницы, быстрый откат, телеметрия.
  • Надёжность — ответственность, а не роскошь. Ей можно жертвовать ради скорости или цены, но осознанно и очень осторожно.

Что далее

Надежность Пройдено
Артём Никифоров
Антон Помазков
Артём Никифоров